AI가 쓴 문서를 다른 AI에게 검사시켰습니다 — AI검수로 잡히는 것과 안 잡히는 것
AI가 쓴 문서를 AI검수로 확인해 봤습니다. 그런데 쓴 쪽에게 검토를 맡기면 거의 안 나옵니다. "문제 없습니다" 로 끝납니다.
다른 AI에게 같은 문서를 검사시켰더니 오류가 여럿 나왔습니다. 존재하지 않는 명령어, 없는 파일 경로, 실행해 본 적 없는 절차가 사실처럼 적혀 있었습니다.
1. 쓴 쪽이 아닌 다른 쪽에게 검사시킵니다 2. "검토해줘" 대신 무엇을 확인할지 지정합니다 3. 검사 결과를 직접 실행해서 다시 확인합니다 4. 검사기가 못 잡는 영역을 알아 둡니다
AI검수 — 왜 쓴 쪽은 자기 오류를 못 잡나
증상 — 작성한 AI에게 "검토해줘" 하면 총평만 돌아옵니다. 구체적인 오류는 거의 안 나옵니다.
원인 — 방금 자기가 만든 내용이 앞에 있으니, 그걸 전제로 놓고 읽습니다. "이 명령어가 실제로 있나" 를 의심하지 않습니다. 자기가 방금 그렇게 썼으니까요.
사람도 비슷합니다. 자기가 쓴 글의 오타를 못 보는 것과 같은 종류입니다.
해결 — 문맥을 모르는 쪽에게 맡깁니다. 앞선 대화 없이 문서만 던져 주면, 전제 없이 읽고 이상한 데를 짚습니다.
검사 프롬프트를 어떻게 쓰나
여기가 결과를 가릅니다. "검토해줘" 는 총평을 부릅니다.
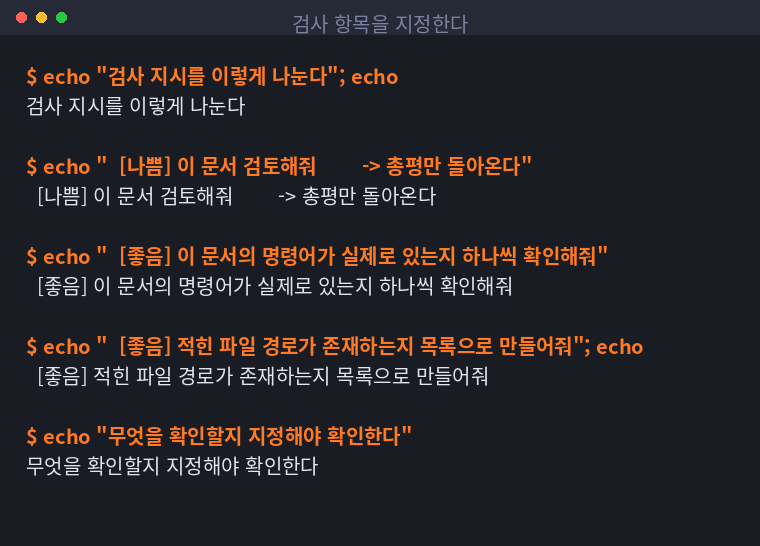
| 지시 | 돌아오는 것 |
|---|---|
| "이 문서 검토해줘" | 총평. "전반적으로 잘 정리됐습니다" |
| "명령어가 실제로 있는지 하나씩 확인해줘" | 명령어 목록과 판정 |
| "적힌 파일 경로를 목록으로 만들어줘" | 경로 목록 |
| "앞뒤가 안 맞는 곳을 찾아줘" | 모순 지점 |
확인할 항목을 지정해야 확인합니다. 저는 처음에 "꼼꼼히 검토해줘" 라고 썼는데, 꼼꼼함은 지시가 아니었습니다.
목록으로 받는 것도 중요합니다. 문장으로 받으면 넘어가기 쉬운데, 목록이면 하나씩 대조하게 됩니다.
지시 예:
이 문서에 나오는 모든 명령어와 파일 경로를 표로 만들어라.
각 항목에 대해 "문서에 적힌 대로" 와 "실제로 존재하는지 확인 필요"
두 칸으로 나눠 적어라. 판단하지 말고 목록만 만들어라.
판단을 시키지 말고 목록을 만들게 하는 것이 요령이었습니다. 판단을 시키면 대충 넘어가는데, 목록을 만들라고 하면 빠뜨리지 않습니다.
받은 목록은 그대로 두지 않고 기계로 대조합니다. 경로는 파일이 실제로 있는지 확인하면 끝입니다.
for path in reported_paths:
    exists = Path(path).exists()
    print(f"{'OK ' if exists else '없음'} {path}")
명령어도 마찬가지입니다. command -v 로 한 줄씩 확인하면 있다/없다 가 바로 나옵니다. 검사기의 말을 믿는 대신 시스템에게 물어봅니다.
AI검수에서 실제로 나온 것들
제 경우 이런 것들이 나왔습니다.
| 종류 | 예 |
|---|---|
| 없는 명령어 | 그럴듯한 옵션인데 실제로는 없는 것 |
| 없는 경로 | 폴더 구조를 짐작해서 적은 것 |
| 실행 안 해본 절차 | 순서는 맞는데 중간 단계가 빠진 것 |
| 앞뒤 모순 | 앞에서 A라 하고 뒤에서 B라 한 것 |
공통점이 있습니다. 전부 "그럴듯하다" 는 점입니다. 형식이 맞고 문맥에도 어울려서, 읽을 때는 이상하다고 못 느낍니다.
그래도 안 잡히는 것
여기가 한계입니다. AI 검수로 못 잡는 영역이 분명히 있습니다.
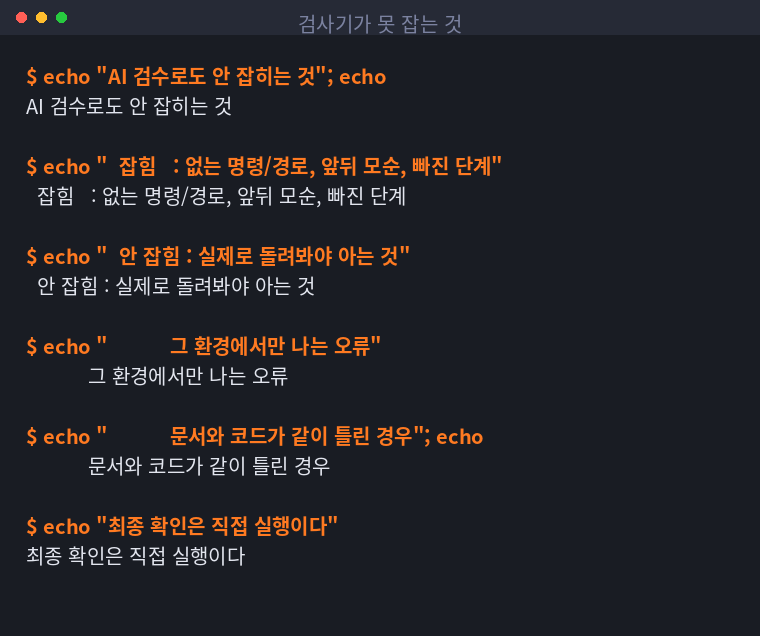
| 잡힙니다 | 안 잡힙니다 |
|---|---|
| 없는 명령어·경로 | 실제로 돌려봐야 아는 것 |
| 앞뒤 모순 | 그 환경에서만 나는 오류 |
| 빠진 단계 | 문서와 코드가 같이 틀린 경우 |
| 형식 오류 | 권한·설정처럼 밖에 있는 조건 |
마지막 줄이 무섭습니다. 문서와 코드가 같이 틀려 있으면 검사기는 둘이 일치한다고 판단합니다. 대조할 기준이 둘 다 틀렸기 때문입니다.
그래서 최종 확인은 직접 실행입니다. 저는 문서에 적은 명령을 실제로 한 번씩 돌려 보고, 나온 화면을 그대로 증거로 남깁니다. 이게 제일 확실했습니다.
주의할 것
검사 결과를 그대로 믿으면 안 됩니다. 검사하는 쪽도 AI라 없는 오류를 만들어 내는 경우가 있었습니다.
저는 검사 결과를 "확인할 목록" 으로 다룹니다. 판정이 아니라 후보입니다. 그중 실제로 문제인 것을 제가 확인합니다.
| 다루는 법 | |
|---|---|
| 검사 결과 = 판정 | ❌ 없는 오류까지 고치게 됩니다 |
| 검사 결과 = 확인 목록 | ✅ 하나씩 직접 대조합니다 |
한 번은 검사기가 "이 명령은 존재하지 않습니다" 라고 했는데 실제로는 있었습니다. 그대로 믿었으면 멀쩡한 문서를 고칠 뻔했습니다.
대안으로 검사 결과를 바로 반영하지 않고 한 단계 두는 방법을 씁니다. 지적된 것을 목록으로 모아 두고, 확인한 것만 고칩니다.
findings = ai_audit(doc)                 # 후보 목록
confirmed = [f for f in findings if verify(f)]   # 기계로 확인한 것만
print(f"지적 {len(findings)}건 중 확인됨 {len(confirmed)}건")
verify() 는 사람이 아니라 시스템이 합니다. 경로면 Path.exists(), 명령이면 command -v, 응답 코드면 실제 호출입니다. 확인이 안 되는 항목만 제가 직접 봅니다.
이렇게 두면 검사기가 틀려도 손해가 없습니다. 확인을 통과 못 하면 그냥 목록에 남을 뿐입니다.
확인 못 한 것
검사기를 여러 개 붙이면 정확도가 오르는지는 확인하지 못했습니다. 둘 이상이 같이 지적한 것만 채택하는 방식이 될 것 같은데, 비용이 배로 들어서 아직 안 해봤습니다.
한쪽이 놓친 것을 다른 쪽이 잡는 경우가 있을지, 아니면 둘 다 같은 것을 놓칠지도 모르겠습니다. 같은 종류의 도구라면 약점도 비슷할 것 같다는 짐작만 있습니다.
판정 — 조건부로 쓸만
독립 검사는 확실히 값어치가 있습니다. 자기 검토에서 안 나오던 것이 여럿 나왔습니다. 붙이는 비용도 낮습니다.
다만 검사만으로 끝내면 안 됩니다. 못 잡는 영역이 분명하고, 없는 오류를 만들기도 합니다. 직접 실행이 최종 확인입니다.
항목을 지정해야 씁니다. "검토해줘" 로는 총평만 옵니다. 이 차이가 생각보다 큽니다.
직접 하실 분께
하나. 쓴 쪽에게 검토를 맡기지 마세요. 문맥을 모르는 쪽에게 던지는 게 핵심입니다.
둘. 확인할 항목을 지정합니다. 판단이 아니라 목록을 만들게 하면 덜 빠뜨립니다.
셋. 검사 결과는 확인 목록으로 다룹니다. 그대로 믿으면 멀쩡한 것도 고칩니다.
넷. 문서에 적은 명령은 한 번씩 실제로 돌려 봅니다. 확실한 확인은 이것뿐입니다.
다음에는 검사기를 둘 이상 붙여서 겹치는 지적만 채택하는 방식이 실제로 나은지 확인해보려고 합니다. 되면 이어서 적겠습니다.