계산은 맞는데 의미가 틀렸습니다 — AI분석이 만든 숫자를 검증하는 법
AI분석으로 데이터를 요약하게 시켰더니 그럴듯한 비율이 나왔습니다. 계산도 맞았습니다.
그런데 그 두 숫자는 서로 비교할 대상이 아니었습니다. 산술은 맞고 의미는 틀린 결과였습니다.
1. 각 숫자가 무엇의 개수인지 확인합니다 2. 두 숫자의 단위가 같은지 봅니다 3. 분모가 분자를 포함하는지 확인합니다 4. 값에 이름을 붙여 다루면 애초에 안 섞입니다
AI분석 증상 — 그럴듯한 비율이 나옵니다
증상 — 긴 자료를 주고 요약하게 했더니 비율이 나왔습니다. 숫자도 자연스럽고 계산도 맞습니다.
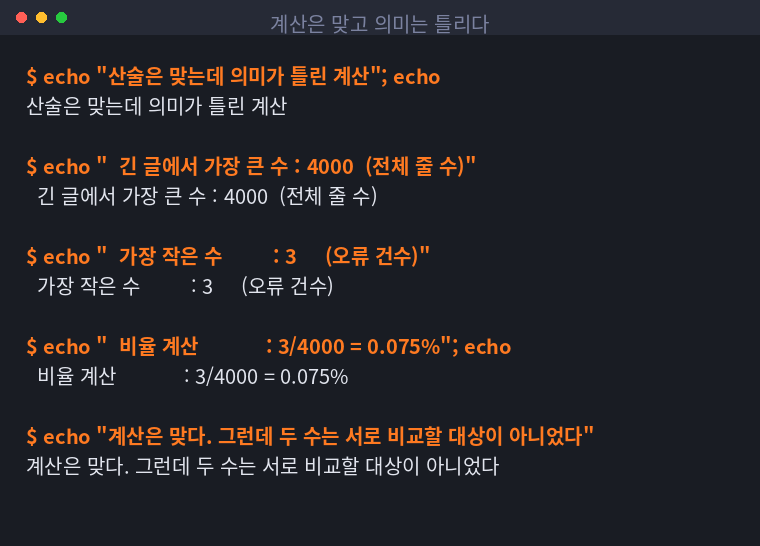
원인 — 자료 안에서 눈에 띄는 숫자 두 개를 뽑아 나눈 것이었습니다. 하나는 전체 줄 수, 하나는 오류 건수였습니다.
둘 다 그 자료에 있는 숫자이긴 합니다. 다만 서로 관계가 없습니다. 전체 줄 수에는 오류가 아닌 줄이 대부분이고, 오류 건수는 다른 방식으로 센 값입니다.
이런 계산은 틀렸다고 알아채기가 어렵습니다. 숫자가 이상하게 크거나 작지 않고, 소수점 자리도 그럴듯합니다. 저는 그 값을 그대로 보고서에 옮겨 적었습니다.
왜 이런 일이 생기나
원인 — 생성 쪽은 "그럴듯한 답" 을 만듭니다. 비율을 물어보면 자료에서 숫자 두 개를 찾아 나눕니다.
두 숫자가 비교 가능한지는 안 봅니다. 그건 자료의 맥락을 알아야 판단할 수 있는데, 긴 텍스트만 던져 주면 그 맥락이 없습니다.
| 잘 틀리는 짝 | 왜 |
|---|---|
| 전체 줄 수 ÷ 항목 수 | 단위가 다릅니다 |
| 오늘 값 ÷ 누적 값 | 기간이 다릅니다 |
| 성공 건수 ÷ 전체 사용자 수 | 분모가 분자를 안 포함합니다 |
| 최댓값 ÷ 최솟값 | 아무 관계 없는 두 수 |
마지막 줄이 제 경우였습니다. "가장 큰 수" 와 "가장 작은 수" 는 그냥 크기가 다른 두 수지, 비율을 낼 짝이 아닙니다.
해결 — 숫자를 쓰기 전에 넷을 묻습니다
해결 — 나온 숫자를 그대로 옮기지 않고 확인합니다.
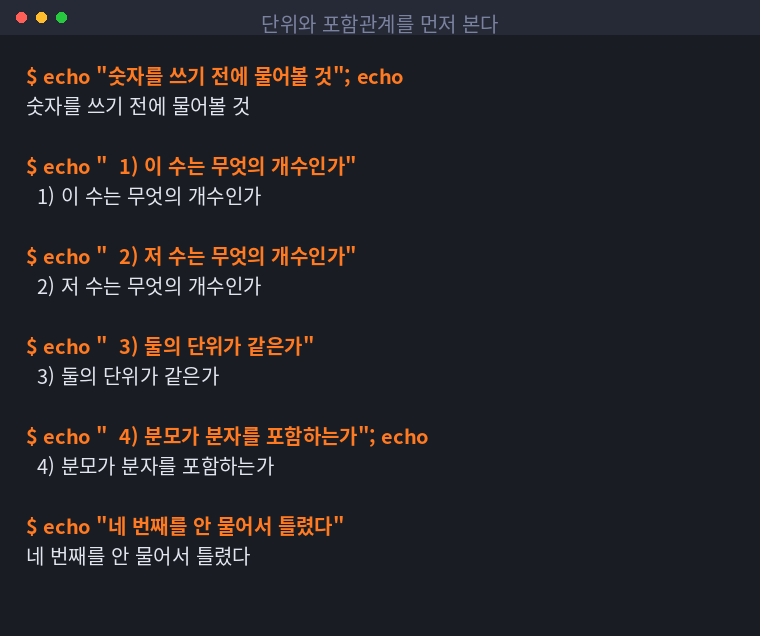
| 물어볼 것 | 확인 방법 |
|---|---|
| 이 수는 무엇의 개수인가 | 자료에서 그 수가 나온 자리를 찾습니다 |
| 저 수는 무엇의 개수인가 | 같은 방식으로 찾습니다 |
| 단위가 같은가 | 줄·건·명·원이 섞이지 않았는지 |
| 분모가 분자를 포함하는가 | 비율이라면 반드시 포함해야 합니다 |
네 번째를 제일 자주 빠뜨립니다. 비율이라는 말이 붙으면 "부분 ÷ 전체" 일 거라고 넘어갑니다.
저는 이걸 안 물어서 틀렸습니다. 물어봤다면 "전체 줄 수에 오류 건수가 포함되나?" 에서 바로 걸렸을 겁니다.
근본 해결 — 값에 이름을 붙입니다
대안 — 애초에 숫자를 이름 없이 다루지 않는 것이 낫습니다.
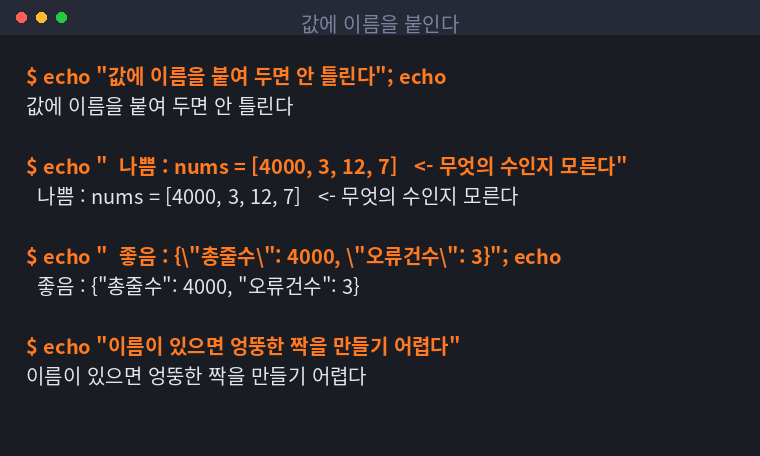
# 나쁨: 무엇의 수인지 모른 채 뭉쳐 둔다
nums = [4000, 3, 12, 7]
ratio = min(nums) / max(nums)          # 아무 짝이나 만들어진다

# 좋음: 이름을 붙여 둔다
stats = {"총_줄수": 4000, "오류_건수": 3, "경고_건수": 12}
ratio = stats["오류_건수"] / stats["총_줄수"]   # 짝이 눈에 보인다
이름이 있으면 엉뚱한 짝을 만들기 어렵습니다. 코드를 읽는 사람도 바로 이상하다고 느낍니다.
AI에게 시킬 때도 마찬가지입니다. "비율을 내라" 대신 무엇을 무엇으로 나눌지 지정합니다.
나쁨: 이 자료에서 오류 비율을 계산해줘
좋음: '오류' 로 표시된 줄 수를 세고, 전체 줄 수로 나눠라.
      두 값을 각각 먼저 출력한 뒤 나눈 결과를 적어라.
중간값을 먼저 출력하게 하는 것이 요령이었습니다. 그 두 수만 봐도 짝이 맞는지 판단이 됩니다.
저는 이렇게 바꾸고 나서 결과를 훨씬 빨리 검토하게 됐습니다. 전에는 비율 하나만 보고 "맞나?" 를 고민했는데, 지금은 3 / 4000 처럼 두 수가 같이 나오니 이상하면 바로 보입니다.
그리고 비율을 아예 안 만들게 하는 방법도 씁니다. 개수만 받아서 나누는 건 제가 코드로 합니다. 그러면 짝을 잘못 고를 일이 없습니다.
데이터 검산은 기계로 합니다
주의 — 나온 비율을 눈으로 검토해도 잘 안 걸립니다. 값 자체는 이상하지 않으니까요.
분모와 분자를 각각 다시 세는 편이 확실했습니다.
total = sum(1 for _ in open(path))                    # 총 줄 수
errors = sum(1 for l in open(path) if "ERROR" in l)   # 오류 줄 수
assert errors <= total, "분자가 분모보다 큽니다"
print(f"{errors}/{total} = {errors/total:.2%}")
assert 한 줄이 의외로 많이 잡습니다. 분자가 분모보다 크면 그 짝은 확실히 틀린 것입니다.
저는 이걸 넣고 나서 다른 자리에서도 하나를 더 찾았습니다. 기간이 다른 두 값을 나누고 있었는데, 값의 크기는 자연스러워서 눈으로는 못 봤습니다. assert 가 걸리고 나서야 확인했습니다.
범위 검사도 같이 넣어 두면 좋습니다. 비율이라면 0과 1 사이여야 합니다.
assert 0 <= ratio <= 1, f"비율이 범위를 벗어남: {ratio}"
이것도 여러 번 걸렸습니다. 대부분 분모와 분자를 거꾸로 넣은 경우였습니다.
확인 못 한 것
어떤 짝이 말이 되는지 자동으로 판단할 수 있는지는 확인하지 못했습니다. 단위를 값에 같이 붙여 두면 될 것 같은데, 단위가 같아도 의미가 안 맞는 경우가 있어서 그것만으로는 부족해 보입니다.
3건과 4000건은 단위가 같지만 여전히 비교 대상이 아닐 수 있습니다. 여기까지는 사람이 봐야 하는 영역 같은데, 확신은 없습니다.
판정 — 계속 쓴다
AI로 자료를 요약하는 것 자체는 계속 씁니다. 긴 자료에서 흐름을 잡는 데는 확실히 빠릅니다.
다만 나온 숫자를 그대로 옮기지 않습니다. 비율이 나오면 분모와 분자가 무엇인지 확인하고, 필요하면 직접 다시 셉니다.
값에 이름을 붙이는 습관이 제일 효과가 컸습니다. 이름이 있으면 엉뚱한 짝이 눈에 띕니다.
직접 하실 분께
하나. 비율이 나오면 분모와 분자가 무엇인지 부터 확인하세요.
둘. 분모가 분자를 포함하는지 봅니다. 이걸 제일 자주 빠뜨립니다.
셋. AI에게 시킬 때 중간값을 먼저 출력하게 합니다. 그 두 수만 봐도 판단이 됩니다.
넷. 값은 이름을 붙여 다룹니다. 숫자만 모아 두면 아무 짝이나 만들어집니다.
다음에는 값에 단위를 같이 붙여 두고 짝이 맞는지 자동으로 걸러낼 수 있는지 해보려고 합니다. 되면 이어서 적겠습니다.