자기 점수를 자기가 매기면 안 되는 이유 — AI검수에서 자기평가가 근거가 못 되는 지점
AI검수 결과를 점수로 보여주는 화면을 만들었습니다. 숫자가 높게 나와서 잘 되고 있는 줄 알았습니다.
들여다보니 채점 기준을 만든 쪽과 채점한 쪽이 같았습니다. 그 점수는 근거가 아니었습니다.
1. 채점 기준이 누가 정한 것인지 확인합니다 2. 채점을 누가 하는지 확인합니다 3. 빈 값을 어느 쪽으로 읽는지 확인합니다 4. 셋 중 하나라도 같은 쪽이면 그 점수는 근거로 안 씁니다
AI검수 증상 — 자기평가 점수가 늘 높습니다
증상 — 만든 것을 스스로 평가하면 대체로 점수가 높게 나옵니다. 낮게 나오는 경우가 거의 없습니다.
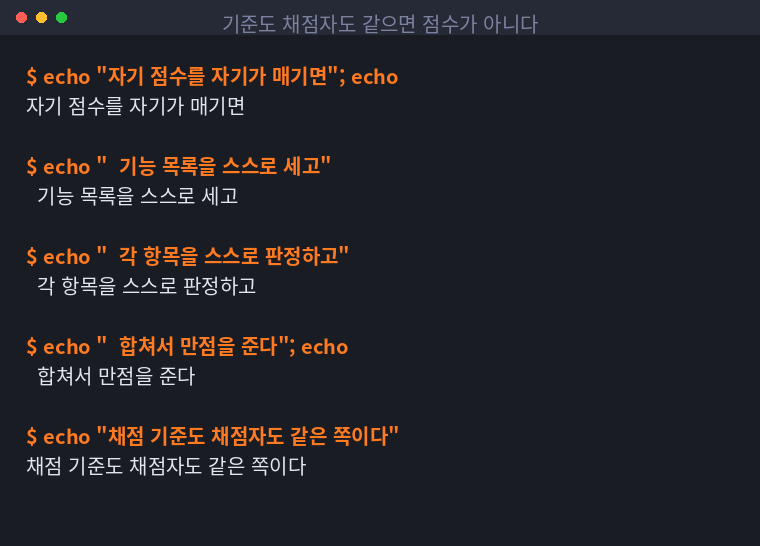
원인 — 구조가 이렇게 돼 있었습니다.
- 무엇을 볼지(기능 목록)를 스스로 정하고
- 각 항목이 됐는지를 스스로 판정하고
- 합쳐서 점수를 냅니다
세 단계가 전부 같은 쪽입니다. 이러면 점수가 아니라 자기소개입니다.
저는 이걸 만들 때 문제라고 생각 못 했습니다. 기준을 나름 촘촘하게 짰으니 괜찮다고 봤습니다. 기준이 촘촘한 것과 독립적인 것은 다른 문제였습니다.
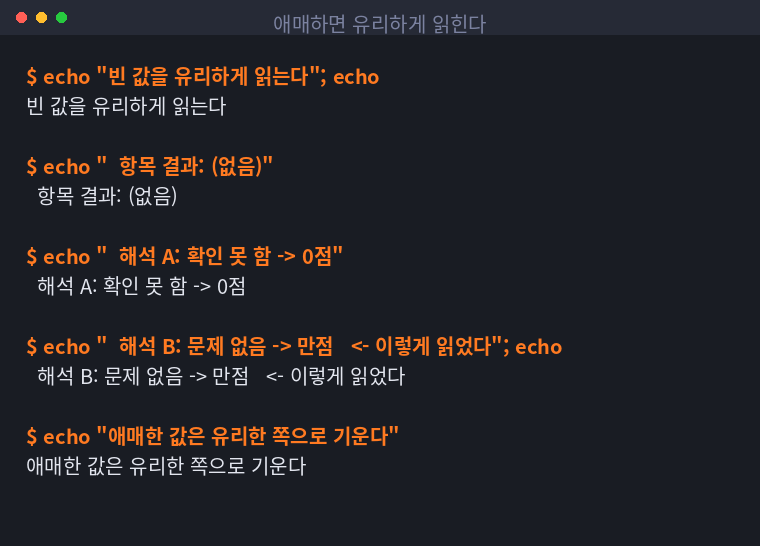
빈 값을 유리하게 읽습니다
증상 — 확인이 안 된 항목이 만점으로 계산되고 있었습니다.
# 나쁨: 결과가 없으면 문제도 없는 것으로 읽는다
issues = check(item) or []
score += 10 if not issues else 0      # 검사 실패도 만점이 된다
| 결과 | 읽을 수 있는 방식 | 어느 쪽을 골랐나 |
|---|---|---|
[] |
문제 없음 / 확인 못 함 | 문제 없음 |
None |
검사 안 함 | 문제 없음 |
| 오류 | 판단 불가 | 문제 없음 |
애매한 값은 유리한 쪽으로 기웁니다. 일부러 그런 게 아니라, 그렇게 쓰는 게 코드가 짧아서 그렇게 됐습니다.
해결 — 빈 값은 0점으로 정합니다. 그리고 검사 여부를 따로 남깁니다.
result = {"checked": False, "issues": []}
try:
    result = {"checked": True, "issues": check(item)}
except Exception as e:
    log(f"검사 실패: {e}")

score += 10 if (result["checked"] and not result["issues"]) else 0
해결 — AI검수에 독립 기준을 만듭니다
해결 — 세 단계 중 최소한 하나는 다른 쪽에 둡니다.
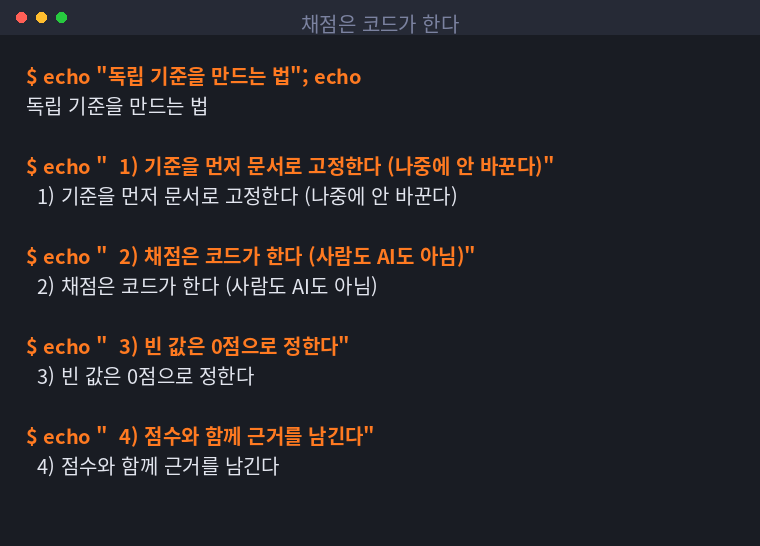
| 단계 | 어떻게 |
|---|---|
| 기준 정하기 | 먼저 문서로 고정합니다. 채점하면서 안 바꿉니다 |
| 채점하기 | 코드가 합니다. 사람도 AI도 아닙니다 |
| 빈 값 처리 | 0점으로 미리 정해 둡니다 |
| 근거 남기기 | 점수와 함께 왜 그 점수인지를 같이 남깁니다 |
기준을 먼저 고정하는 게 핵심입니다. 채점하다가 "이 항목은 좀 과한데" 하고 기준을 낮추면, 그 순간 다시 자기 채점이 됩니다.
저는 기준 문서를 따로 만들고, 채점기가 그 문서의 항목만 보게 했습니다. 기준을 바꾸려면 문서를 먼저 고쳐야 합니다.
주의 — 코드가 채점해도 그 코드를 내가 짰으면 완전히 독립적이진 않습니다. 다만 기준이 고정되고 계산이 일정하다는 점에서 훨씬 낫습니다. 최소한 같은 글에 같은 점수가 나옵니다.
표현도 정정해야 합니다
점수가 근거가 아니었다는 걸 알고 나서, 이미 적어 둔 표현들을 정정했습니다.
| 전 | 후 |
|---|---|
| "품질 만점" | "자체 기준 기준으로 만점 (독립 검증 아님)" |
| "전부 확인됨" | "3개 항목 중 3개 확인, 나머지는 미확인" |
| "문제 없음" | "확인한 범위에서 문제 없음" |
표현을 낮추는 게 손해처럼 느껴지는데 그렇지 않았습니다. 나중에 실제 문제가 나왔을 때 "만점이라며" 가 되는 것보다, 처음부터 범위를 밝히는 쪽이 낫습니다.
저는 이걸 정정하면서 이전에 적어 둔 문장들을 다시 훑었습니다. 생각보다 많았습니다. "완료", "이상 없음", "전부 확인" 같은 표현이 곳곳에 있었는데, 실제로 확인한 범위는 그보다 훨씬 좁았습니다.
점수 자체를 없애지는 않았습니다. 자체 기준으로 매긴 점수라고 옆에 적어 두는 것만으로 오해가 줄었습니다.
확인 못 한 것
완전히 독립적인 채점을 어떻게 만들 수 있는지는 아직 답을 못 찾았습니다. 기준도 코드도 결국 제가 만든 것입니다.
다른 사람이 만든 기준을 쓰거나, 밖에서 측정되는 값(실제 방문·검색 노출 같은 것)을 쓰면 될 것 같은데, 그건 시간이 걸리는 지표라 만들자마자 쓸 수는 없습니다.
자체 점수가 실제 결과와 얼마나 맞는지도 확인하지 못했습니다. 점수가 높은 글이 정말 더 잘 읽히는지는 데이터가 쌓여야 알 수 있는데, 아직 그만큼 안 모였습니다.
지금은 자체 점수를 쓰되 그게 자체 점수라고 밝히는 선에서 두고 있습니다. 점수를 출력할 때 항상 기준을 같이 적습니다.
print(f"{total}점 / {TARGET}점 (자체 기준 · 독립 검증 아님)")
for d in dims:
    print(f"  {d['name']}: {d['earned']}/{d['max']}  {d['note']}")
항목별 내역을 같이 내는 것도 도움이 됐습니다. 총점만 보면 "높다/낮다" 로 끝나는데, 어느 항목에서 깎였는지가 보이면 판단할 여지가 생깁니다.
판정 — 안 쓰기로 했다
자기 채점 점수를 "근거" 로 쓰는 것은 접었습니다. 참고 지표로는 쓰지만, 그걸로 뭔가를 증명하지 않습니다.
대신 기준을 고정하고 코드가 채점하게 바꿨습니다. 완전히 독립적이진 않아도, 같은 글에 같은 점수가 나오고 기준을 몰래 못 바꿉니다.
빈 값을 0점으로 정한 것이 실제로 제일 큰 변화였습니다. 그것만으로 점수가 눈에 띄게 내려갔습니다. 그전 점수가 부풀려져 있었다는 뜻입니다.
직접 하실 분께
하나. 점수를 보면 기준을 누가 정했는지 부터 확인하세요. 만든 쪽이 정했으면 그건 자기소개입니다.
둘. 빈 값과 오류를 0점으로 정합니다. 유리하게 읽으면 점수가 부풀려집니다.
셋. 기준은 먼저 문서로 고정합니다. 채점하면서 바꾸면 의미가 없습니다.
넷. 점수를 말할 때 "자체 기준" 이라고 밝힙니다. 나중에 정정하는 것보다 낫습니다.
다음에는 밖에서 측정되는 지표로 자체 점수가 맞았는지 대조해보려고 합니다. 시간이 걸리지만 되면 이어서 적겠습니다.