서치콘솔 API로 검색어 읽어오기 — 403이 나는 두 가지 이유
서치콘솔 화면에서 보이는 검색어·노출수·클릭수를 API로 읽어오면 다른 데이터와 합쳐 볼 수 있습니다. 방문 분석 도구에는 검색어가 없어서, 검색어까지 보려면 이 길밖에 없습니다.
문제는 내 계정으로 로그인이 돼 있어도 프로그램은 못 읽는다는 점입니다. 여기서 403이 나고, 원인이 둘인데 증상이 똑같아서 구분이 어렵습니다.
순서는 이렇습니다.
1. 서비스 계정을 만들고 키를 받습니다 2. 클라우드 프로젝트에서 서치콘솔 API를 사용 설정합니다 3. 서치콘솔 속성에 그 계정을 사용자로 추가합니다 4. 조회합니다
왜 로그인만으론 안 되나
화면에 로그인한 것은 사람인 나입니다. 프로그램은 사람이 아니라서 자기 신분이 따로 필요합니다. 그게 서비스 계정입니다.
| 사람 로그인 | 서비스 계정 | |
|---|---|---|
| 누가 | 나 | 프로그램 |
| 인증 | 비밀번호·2단계 | JSON 키 파일 |
| 권한 | 내가 만든 속성 전부 | 속성마다 따로 줘야 함 |
마지막 줄이 핵심입니다. 서비스 계정을 만들었다고 내 속성이 자동으로 보이지 않습니다.
403이 나는 두 가지 이유
증상이 같아서 이걸 구분 못 하면 계속 헤맵니다.
| 원인 | 어디를 고치나 | 증상 |
|---|---|---|
| API를 사용 설정 안 함 | 클라우드 콘솔 → API 라이브러리 | 호출 자체가 거부됨 |
| 속성에 계정을 안 넣음 | 서치콘솔 → 설정 → 사용자 및 권한 | 호출은 되는데 내 사이트가 안 보임 |
둘 중 하나만 해도 안 됩니다. 저는 이걸 몰라서 키를 새로 만들고 스코프를 바꿔가며 한참 봤습니다. 인증 코드는 처음부터 맞았습니다.
구분하는 방법이 있습니다. 토큰이 나오는지, 목록에 내 사이트가 있는지를 나눠서 확인하면 됩니다.
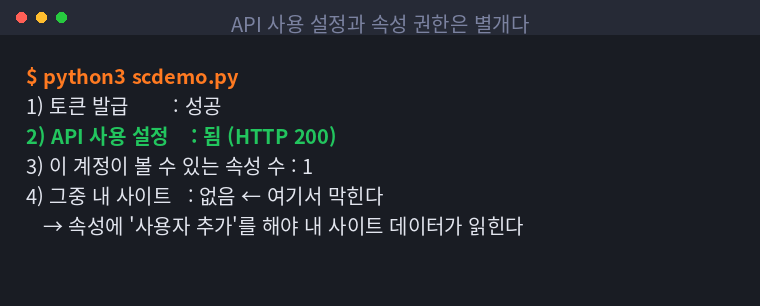
- 토큰 발급이 실패한다 → 키 파일 문제
- 토큰은 나오는데 호출이 막힌다 → API 사용 설정 안 됨
- 호출은 되는데 목록이 비어 있다 → 속성 권한 없음
세 번째가 제일 헷갈립니다. 200이 돌아오니 성공처럼 보이는데, 내용이 비어 있습니다. 저는 이 상태에서 응답 코드만 보고 "연결됐다"고 판단했다가, 며칠 뒤 데이터가 하나도 안 쌓인 걸 보고 다시 봤습니다.
이 세 줄을 그대로 스크립트로 만들어 두면 다음에 막혔을 때 30초면 원인이 나옵니다.
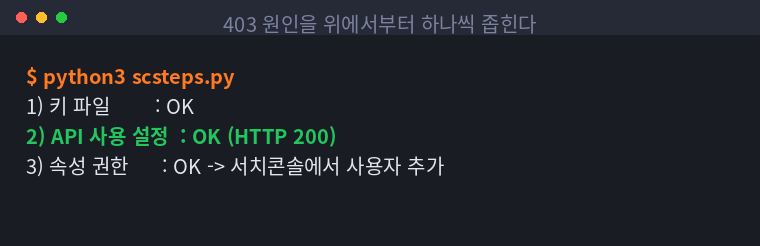
한 번에 다 던져놓고 결과만 보면 어느 단계가 문제인지 구분이 안 됩니다. 저는 처음에 그렇게 만들어서 인증부터 의심했고, 정작 원인은 마지막 단계였습니다.
고치는 법
하나. API 사용 설정
증상 — 토큰은 나오는데 호출이 거부됩니다.
원인 — 클라우드 프로젝트마다 쓸 API를 켜야 합니다. 기본은 꺼져 있습니다.
해결 — 클라우드 콘솔 → API 및 서비스 → 라이브러리 → 검색해서 사용 을 누릅니다. 몇 분 뒤 반영됩니다.
둘. 속성에 계정 추가
증상 — 호출은 200 인데 사이트 목록이 비어 있습니다.
원인 — 그 서비스 계정이 아직 어떤 속성에도 등록되지 않았습니다.
해결 — 서치콘솔 → 설정 → 사용자 및 권한 → 사용자 추가 → 서비스 계정 이메일을 넣습니다. 사람 이메일이 아니라 ...iam.gserviceaccount.com 으로 끝나는 그 주소입니다.
권한은 제한적으로 충분합니다. 읽기만 할 것이면 더 줄 이유가 없습니다.
조회 코드
from google.auth.transport.requests import Request
from google.oauth2 import service_account
import json, urllib.request, urllib.parse

SCOPE = "https://www.googleapis.com/auth/webmasters.readonly"
cred = service_account.Credentials.from_service_account_file(KEY_PATH, scopes=[SCOPE])
cred.refresh(Request())

site = urllib.parse.quote("https://내주소/", safe="")
url = f"https://searchconsole.googleapis.com/webmasters/v3/sites/{site}/searchAnalytics/query"
body = {
    "startDate": "2026-08-01", "endDate": "2026-08-07",
    "dimensions": ["query"],          # 검색어별
    "rowLimit": 25,
}
dimensions 를 바꾸면 보는 각도가 달라집니다.
| 값 | 무엇이 나오나 |
|---|---|
query |
검색어별 노출·클릭 |
page |
글 주소별 |
query, page |
어느 글이 어떤 검색어로 잡히는지 |
date |
날짜별 추이 |
device |
기기별 |
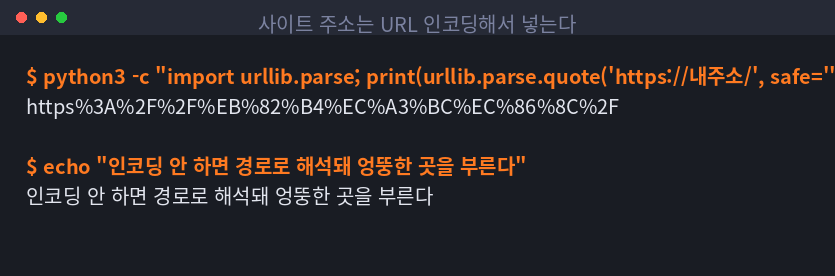
사이트 주소를 URL 인코딩해야 합니다. 그냥 넣으면 슬래시가 경로 구분자로 해석돼 엉뚱한 곳을 부릅니다. 이것도 한 번 걸렸습니다.
import urllib.parse
site = urllib.parse.quote("https://내주소/", safe="")
# https%3A%2F%2F내주소%2F
끝의 슬래시도 등록한 것과 정확히 같아야 합니다. 서치콘솔에 https://내주소/ 로 등록해 놓고 조회할 때 슬래시를 빼면 다른 속성으로 취급됩니다. 저는 여기서도 한 번 헤맸습니다.
알아둘 제약
| 제약 | 내용 |
|---|---|
| 데이터 지연 | 2~3일 전까지만 나옵니다. 어제 데이터는 없습니다 |
| 보관 기간 | 16개월. 그 이전은 안 나옵니다 |
| 검색어 누락 | 검색량이 적은 검색어는 개인정보 보호로 빠집니다 |
| 합계 불일치 | 검색어별 합이 전체 합과 다릅니다. 위 이유 때문입니다 |
마지막 줄이 처음엔 오류로 보입니다. 정상입니다. 검색량이 아주 적은 검색어는 개인을 특정할 수 있어서 아예 응답에서 빠지는데, 그만큼이 합계에서 비게 됩니다.
그래서 검색어별 숫자를 더해서 전체 수치로 쓰면 계속 어긋납니다. 전체는 전체대로 따로 받아야 합니다. 저는 이걸 모르고 합이 안 맞아서 조회 코드를 여러 번 고쳤습니다. 코드는 처음부터 맞았습니다.
지연도 감안해야 합니다. 오늘 올린 글이 언제부터 이 데이터에 잡히는지는 색인 시점에 달려 있어서, 글을 올리자마자 확인하면 아무것도 안 나옵니다.
방문 분석과 합칠 때
검색어는 서치콘솔, 방문 흐름은 방문 분석 도구에 있습니다. 두 쪽을 붙이려면 글 주소를 기준으로 맞춰야 합니다.
다만 서치콘솔의 주소는 https:// 가 붙은 전체 주소이고, 방문 분석 쪽은 /p/글주소/ 같은 경로만 오는 경우가 많습니다. 형태를 맞춰 주지 않으면 하나도 안 붙습니다.
저는 이 둘을 한 화면에서 이어 보는 것까지는 아직 못 만들었습니다. 주소 형태를 맞추면 될 것 같은데, 검색어별 방문 흐름까지 이어지는지는 확인하지 못했습니다.
확인 순서
| 확인 | 방법 | 정상 |
|---|---|---|
| 키 파일 | 토큰 발급 | 성공 |
| API 사용 설정 | 사이트 목록 호출 | HTTP 200 |
| 속성 권한 | 목록에 내 사이트가 있나 | 있음 |
| 데이터 | 검색어 조회 | 행이 나옴 (며칠 지난 날짜로) |
위에서부터 하나씩 확인합니다. 한꺼번에 보면 어디서 막혔는지 구분이 안 됩니다.
판정 — 조건부로 쓸만
검색어를 프로그램으로 읽으려면 사실상 이 길뿐입니다. 방문 분석 도구에는 검색어가 담기지 않기 때문입니다.
다만 붙이는 데 손이 갑니다. 클라우드 콘솔과 서치콘솔 두 곳을 오가야 하고, 403 원인이 둘이라 구분이 어렵습니다. 위 순서를 알면 30분이면 됩니다.
데이터 지연 2~3일은 감안해야 합니다. 실시간 확인 용도로는 못 씁니다. 주 단위로 흐름을 보는 데 씁니다.
직접 하실 분께
하나. 403 이 나면 원인 두 가지를 나눠서 확인합니다. 키부터 다시 만들지 마세요. 저는 그러다 시간을 썼습니다.
둘. 사이트 주소는 URL 인코딩해서 넣습니다.
셋. 검색어별 합계와 전체 합계가 다른 건 정상입니다. 오류로 보고 뒤지지 마세요.
넷. 권한은 읽기만 줍니다. 프로그램에 필요 이상을 주지 않는 편이 안전합니다.
다음에는 검색어와 방문 흐름을 글 주소 기준으로 붙여서 한 화면에 놓아보려고 합니다. 되면 이어서 적겠습니다.