검사기가 여섯 번 틀렸습니다 — AI검수 오탐을 줄이면서 미탐을 안 늘리는 법
AI검수를 자동화에 붙여 두면 안심이 됩니다. 그런데 검사기 자체가 틀립니다. 저는 여섯 번 겪었습니다.
더 나쁜 건 틀린 방향이 한쪽이 아니었다는 점입니다. 정상 원고를 막기도 하고, 막아야 할 것을 통과시키기도 했습니다.
1. 검사기가 무엇에 걸렸는지 실제 값을 남깁니다 2. 오탐인지 진짜인지 하나씩 확인합니다 3. 고칠 때 두 방향을 다 확인합니다 4. 정상 원고 모음과 나쁜 원고 모음을 회귀 검사로 둡니다
검사기가 틀린 여섯 가지 모양
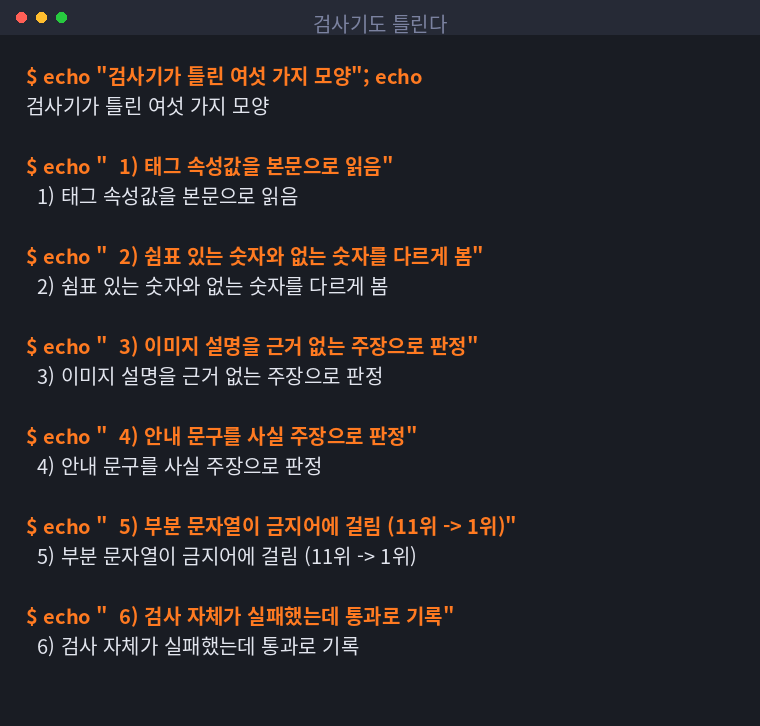
| 모양 | 무슨 일이 났나 |
|---|---|
| 태그 속성값을 본문으로 읽음 | 폭 지정 값이 광고 표현으로 잡힘 |
| 숫자 표기 차이 | 1,200 과 1200 을 다른 값으로 봄 |
| 이미지 설명을 주장으로 판정 | 사진 설명이 "근거 없는 주장" 이 됨 |
| 안내 문구를 사실 주장으로 판정 | "상세는 링크 참고" 가 걸림 |
| 부분 문자열 일치 | 순위 표기 안의 두 글자가 금지어에 걸림 |
| 검사 실패를 통과로 기록 | 결과가 비었는데 문제없음으로 처리 |
앞의 다섯은 오탐입니다. 정상인데 막았습니다. 마지막 하나는 미탐입니다. 확인을 못 했는데 통과시켰습니다.
저는 처음에 오탐만 신경 썼습니다. 막히는 게 눈에 보이니까요. 미탐은 아무 일도 안 일어난 것처럼 보여서 한참 몰랐습니다.
왜 오탐이 생기나
원인 — 대부분 검사 대상을 너무 넓게 잡아서였습니다.
원고 전체를 그대로 검사기에 넣으면 태그·속성·설명이 다 섞여 들어갑니다. 사람 눈에 보이지 않는 것까지 검사받는 셈입니다.
해결 — 검사 대상을 먼저 정리합니다.
# 검사 전에 사람 눈에 보이는 것만 남긴다
text = strip_tags(html)          # 속성·태그 제거
text = normalize_numbers(text)   # 쉼표·단위 표기 통일
hits = check(text)
부분 문자열 일치는 조금 다릅니다. 이건 검사 방식의 문제입니다.
순위를 나타내는 표기가 금지어 목록에 있는데, 앞에 숫자가 하나 더 붙은 표현 안에도 그 두 글자가 들어 있습니다. 단순 포함 검사로는 구분이 안 됩니다.
# 나쁨: 어디에 있든 걸린다 (앞에 숫자가 더 붙은 표현 안에서도)
if BANNED_WORD in text: ...

# 나음: 앞에 숫자가 붙지 않은 경우만 잡는다
if re.search(rf"(?<!\d){re.escape(BANNED_WORD)}", text): ...
저는 이걸 안 고치고 표현을 바꿔서 피했습니다. 규칙 자체를 느슨하게 하는 것보다 안전해 보여서요. 다만 근본 해결은 아닙니다.
덧붙이면 이 글을 쓸 때도 같은 일이 났습니다. 예시를 보여주려고 그 표기를 코드에 그대로 적었더니, 제 검사기가 이 글을 잡았습니다. 채점기는 코드 블록을 검사 대상에서 빼기 때문에 통과했는데, 화면에는 그대로 보입니다. 검사 대상에서 뺀 것이 화면에서도 안 보이는 건 아닙니다.
오탐과 미탐은 맞바꾸는 관계입니다
여기가 핵심입니다. 한쪽을 줄이면 다른 쪽이 늡니다.
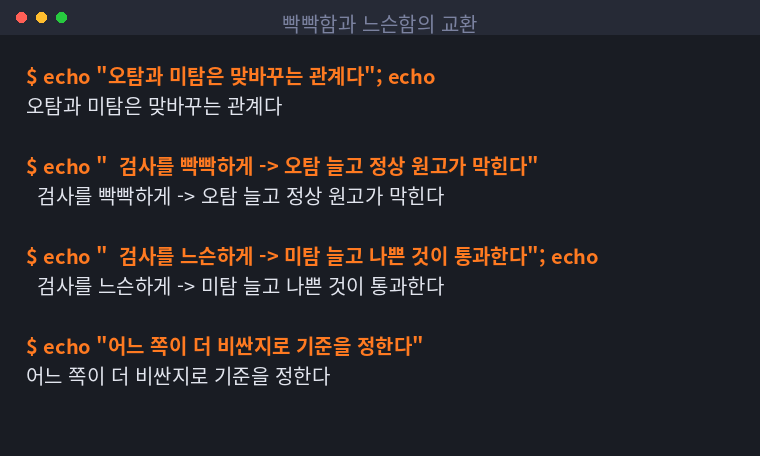
| 검사를 | 오탐 | 미탐 |
|---|---|---|
| 빡빡하게 | 늘어남 (정상이 막힘) | 줄어듦 |
| 느슨하게 | 줄어듦 | 늘어남 (나쁜 게 통과) |
어느 쪽이 더 비싼지로 정합니다.
| 상황 | 어느 쪽으로 |
|---|---|
| 법 위반·개인정보 | 빡빡하게. 미탐 하나가 사고입니다 |
| 문체·분량 | 느슨하게. 오탐이 더 비쌉니다 |
| 사람이 최종 확인하는 구조 | 느슨해도 됩니다 |
| 사람 없이 자동 발행 | 빡빡해야 합니다 |
저는 이 구분을 안 하고 전부 빡빡하게 뒀다가 아무것도 안 나가는 상태를 만들었습니다. 안전한 게 아니라 정지였습니다.
고칠 때 두 방향을 다 확인합니다
주의 — 오탐을 고치다 보면 검사기를 망가뜨립니다. 통과되는 걸 확인하고 끝내면, 막아야 할 것까지 통과하게 만들어 놓고도 모릅니다.
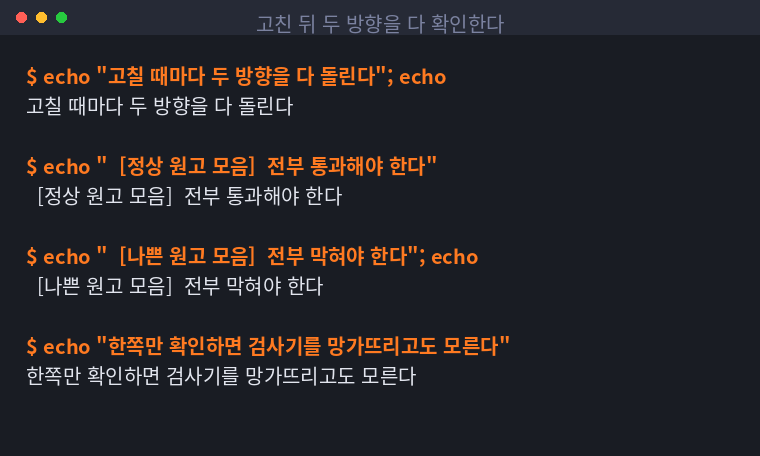
# 두 모음을 만들어 두고 고칠 때마다 둘 다 돌린다
for html in SHOULD_PASS:          # 실제로 막혔던 정상 원고들
    assert not check(html), f"아직 막힌다: {html[:30]}"

for html in SHOULD_BLOCK:         # 진짜 막아야 하는 원고들
    assert check(html), f"통과해 버린다: {html[:30]}"
두 번째 모음을 만드는 게 귀찮습니다. 그래서 저는 처음에 안 만들었습니다. 나중에 검사기를 몇 번 고치고 나서, 그게 아직 제대로 막는지 확인할 방법이 없다는 걸 깨달았습니다.
막혔던 원고는 자연스럽게 쌓입니다. 일부러 나쁜 예를 만들어 두는 것만 따로 해야 합니다.
검사 실패를 통과로 기록하지 않기
여섯 번째가 제일 위험했습니다. 검사가 실패했는데 문제없음으로 기록되고 있었습니다.
# 나쁨: 오류가 나면 빈 결과 -> 문제없음으로 보인다
try:
    hits = check(text)
except Exception:
    hits = []                    # 여기서 "깨끗함" 이 된다

# 나음: 검사 여부를 따로 남긴다
result = {"checked": False, "hits": []}
try:
    result = {"checked": True, "hits": check(text)}
except Exception as e:
    log(f"검사 실패: {e}")

if not result["checked"]:
    block("검사를 못 했습니다")
"오류 없음" 과 "검사 안 함" 이 같은 값으로 표현되면 구분할 방법이 없습니다. checked 같은 필드를 따로 두는 편이 확실합니다.
확인 못 한 것
오탐률을 몇 퍼센트까지 낮춰야 쓸 만한지 는 기준을 못 잡았습니다. 지금은 막힌 원고를 사람이 보고 판단하는데, 그 양이 얼마여야 적당한지 모르겠습니다.
하루에 한두 건이면 볼 만하고 열 건이면 안 보게 될 것 같은데, 실제로 재보지는 않았습니다. 숫자로 기준을 잡아야 할 것 같습니다.
판정 — 계속 쓴다
검사기는 있어야 합니다. 없으면 사람이 매번 봐야 하는데 그게 더 안 됩니다.
다만 검사기를 믿으면 안 됩니다. 검사기도 틀립니다. 걸린 값을 로그에 남기고 정기적으로 훑어보는 게 필요했습니다.
두 방향 회귀 검사가 제일 값어치 있었습니다. 이걸 만들고 나서 검사기를 고치는 게 무섭지 않아졌습니다.
직접 하실 분께
하나. 검사기가 무엇에 걸렸는지 실제 값을 로그에 남기세요. 이게 없으면 오탐인지 진짜인지 판단을 못 합니다.
둘. 항목마다 빡빡함을 다르게 둡니다. 전부 빡빡하면 아무것도 안 나갑니다.
셋. 고칠 때 정상 원고와 나쁜 원고를 둘 다 돌립니다. 한쪽만 보면 망가뜨리고도 모릅니다.
넷. "검사 안 함" 을 "문제 없음" 과 다른 값으로 남깁니다. 같으면 구분이 안 됩니다.
다음에는 오탐이 하루 몇 건까지면 실제로 사람이 계속 볼 수 있는지 재보려고 합니다. 되면 이어서 적겠습니다.