AI검수를 통과했다고 정상인 건 아닙니다 — 형식은 맞는데 값이 틀린 파일
AI검수와 형식 검사를 붙여 두고 문서자동화를 돌리고 있었습니다. 만들어진 파일이 검사를 전부 통과했습니다.
그런데 실제로 열어 보니 이상했습니다. 크기 값 하나가 음수였습니다.
1. 형식 검사가 무엇까지 보는지 확인합니다 2. 값의 타당성은 따로 검사합니다 3. 정상이던 옛 판과 구조를 대조합니다 4. 찾은 유형을 검사 항목에 추가합니다
AI검수 증상 — 검사는 전부 통과합니다
증상 — 만들어진 파일이 모든 검사를 통과합니다. 그런데 결과물이 이상합니다.
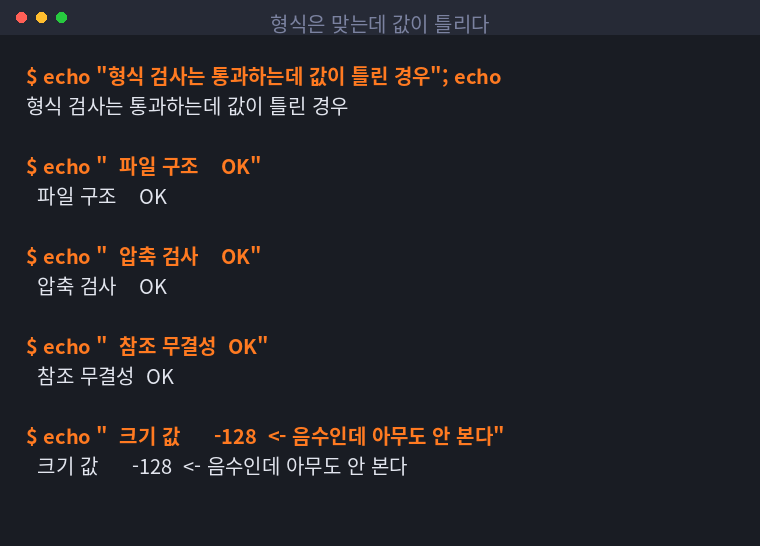
| 검사 항목 | 결과 |
|---|---|
| 파일 구조 | 통과 |
| 압축 무결성 | 통과 |
| 참조 관계 | 통과 |
| 크기 값 | 음수인데 아무도 안 봄 |
원인 — 형식 검사는 "형식이 맞나" 만 봅니다. 값이 말이 되는지는 안 봅니다.
숫자가 들어갈 자리에 숫자가 들어 있으면 통과입니다. 그 숫자가 -128 이어도 형식상으로는 정상입니다. 크기가 음수일 수 없다는 건 사람이 아는 상식이지 형식 규칙이 아닙니다.
저는 이걸 몰라서 "검사를 통과했으니 괜찮겠지" 하고 넘어갔습니다. 검사기가 여러 개 붙어 있으니 더 안심했습니다. 전부 같은 종류의 검사였다는 걸 나중에야 알았습니다.
원인 — 계산이 음수가 될 수 있는 자리
원인 — 값을 계산하는 코드에서 빼기를 하는데, 그 결과가 음수가 될 수 있었습니다.
size = total - used        # used 가 total 보다 크면 음수
write_field("size", size)  # 그대로 기록된다
그리고 파일 형식은 그 값을 그냥 받습니다. 저장할 때 아무도 안 막습니다.
저는 이 코드를 쓸 때 used 가 total 보다 클 수 있다는 생각을 안 했습니다. 논리적으로 그럴 리가 없다고 봤습니다. 실제로는 다른 경로에서 used 가 먼저 갱신되면서 순간적으로 역전되는 경우가 있었습니다.
"그럴 리 없다" 고 생각한 자리가 대개 이렇게 터집니다. 그럴 리 없으니 검사를 안 붙이고, 검사가 없으니 터져도 모릅니다.
이런 자리는 생각보다 많았습니다.
| 자리 | 음수가 되는 경우 |
|---|---|
| 남은 용량 | 사용량이 전체보다 클 때 |
| 경과 시간 | 시계가 뒤로 갔을 때 |
| 개수 차이 | 순서를 바꿔 뺐을 때 |
| 좌표·여백 | 계산 순서가 틀렸을 때 |
문서자동화에서 이걸 어떻게 찾았나
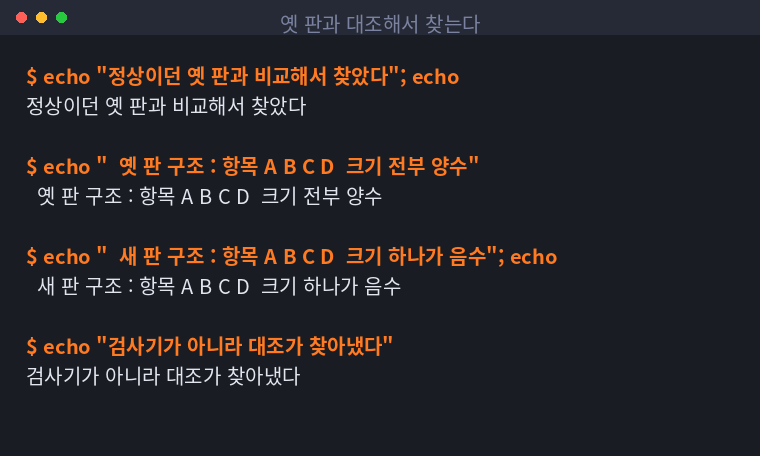
해결 — 검사기로는 못 찾아서 정상이던 옛 판과 대조했습니다.
old = parse(old_file)
new = parse(new_file)

for key in set(old) | set(new):
    a, b = old.get(key), new.get(key)
    if type(a) is not type(b) or (isinstance(a, (int, float)) and (a >= 0) != (b >= 0)):
        print(f"{key}: {a} -> {b}   부호나 형식이 달라졌다")
검사기가 아니라 대조가 찾아냈습니다. 옛 판에는 전부 양수였던 자리에 음수가 하나 있었습니다.
저는 그전까지 이걸 눈으로 찾으려 했습니다. 파일을 열어 값을 훑어봤는데, 항목이 많아서 어느 게 이상한지 판단이 안 됐습니다. -128 도 그냥 숫자로 보였습니다. 무엇과 비교해야 할지를 모르니 이상함을 못 알아본 겁니다.
정상이던 판을 하나 남겨 두는 게 이래서 필요합니다. 비교할 기준이 없으면 "원래 이런가" 를 판단할 수 없습니다. 저는 이 일 뒤로 배포할 때마다 직전 정상 판을 따로 보관합니다.
cp out/result.bin "backup/result-$(date +%Y%m%d-%H%M%S).bin"
용량이 걱정되면 최근 몇 개만 남기면 됩니다. 하나도 없는 것과 하나 있는 것의 차이가 큽니다.
검사 항목에 추가한 것
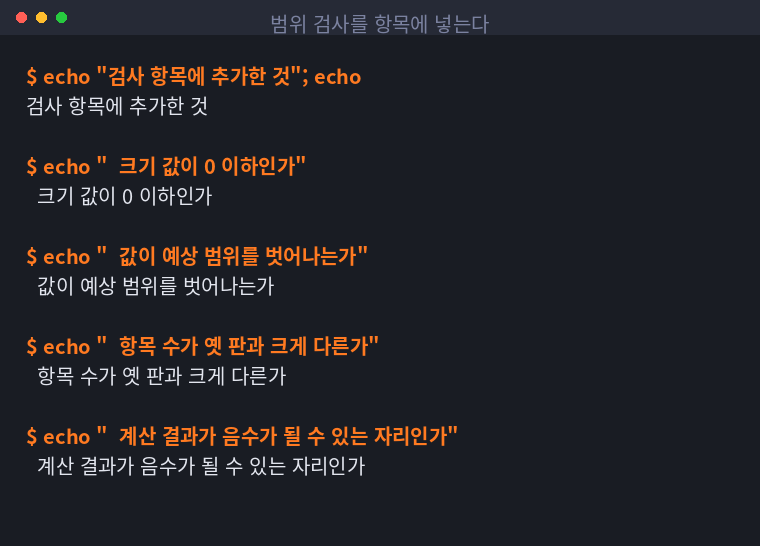
해결 — 값의 타당성을 보는 항목을 따로 넣었습니다.
def sanity_check(fields: dict) -> list[str]:
    """형식이 아니라 '값이 말이 되는가' 를 본다."""
    bad = []
    for k in SIZE_FIELDS:
        if fields.get(k, 0) <= 0:
            bad.append(f"{k} 가 0 이하: {fields[k]}")
    for k, (lo, hi) in RANGES.items():
        v = fields.get(k)
        if v is not None and not (lo <= v <= hi):
            bad.append(f"{k} 가 범위 밖: {v} (기대 {lo}~{hi})")
    if abs(len(fields) - EXPECTED_COUNT) > TOLERANCE:
        bad.append(f"항목 수가 크게 다름: {len(fields)}")
    return bad
| 추가한 검사 | 무엇을 잡나 |
|---|---|
| 크기가 0 이하인가 | 음수·빈 값 |
| 값이 예상 범위 안인가 | 터무니없이 크거나 작은 값 |
| 항목 수가 옛 판과 비슷한가 | 통째로 빠진 부분 |
| 뺄셈 결과가 들어가는 자리인가 | 음수가 될 수 있는 지점 |
마지막 줄은 코드를 보고 표시해 둔 것입니다. 뺄셈이 들어가는 자리는 전부 후보로 봅니다.
검사기를 여러 개 붙여도 안 되는 이유
주의 — 검사기 수를 늘리는 것으로는 해결이 안 됐습니다.
세 개를 붙여 뒀는데 전부 형식 검사였습니다. 같은 종류를 여러 번 하는 셈이라, 형식은 세 번 확인되고 값은 여전히 아무도 안 봅니다.
| 검사 종류 | 무엇을 보나 |
|---|---|
| 형식 검사 | 구조가 규격에 맞나 |
| 타당성 검사 | 값이 말이 되나 |
| 대조 검사 | 이전 판과 크게 다른가 |
| 실행 검사 | 실제로 열어서 써지나 |
성격이 다른 검사를 섞어야 합니다. 같은 종류를 늘리면 개수만 늘고 잡히는 건 그대로입니다.
저는 검사기가 세 개나 되니 꽤 촘촘하다고 생각하고 있었습니다. 실제로는 같은 자리를 세 번 확인하고 나머지는 아무도 안 보는 상태였습니다. 개수가 아니라 종류를 세야 했습니다.
지금은 검사를 붙일 때마다 위 표의 어느 칸인지 적어 둡니다. 빈 칸이 보이면 그쪽부터 채웁니다.
확인 못 한 것
타당성 검사 항목을 자동으로 만들 수 있는지는 확인하지 못했습니다. 지금은 문제가 생길 때마다 하나씩 추가하는 식입니다.
정상 판을 여러 개 모아서 각 값의 범위를 학습시키면 될 것 같기도 한데, 정상 판이 몇 개나 있어야 믿을 만한 범위가 나오는지 모르겠습니다. 그리고 그 범위 자체가 틀리면 오탐이 늘 것 같습니다.
판정 — 계속 쓴다
타당성 검사를 따로 두는 것은 값어치가 큽니다. 형식 검사와 성격이 달라서 잡는 것이 겹치지 않습니다.
정상 판을 남겨 두는 것도 그렇습니다. 비교할 기준이 있어야 "원래 이런가" 를 판단할 수 있습니다.
"검사를 통과했다" 를 "정상이다" 로 읽지 않는 습관이 이 글에서 제일 중요합니다. 검사는 검사하는 것만 봅니다.
직접 하실 분께
하나. 붙여 둔 검사기가 각각 무엇을 보는지 적어 보세요. 전부 같은 종류일 수 있습니다.
둘. 값이 음수가 될 수 있는 자리를 코드에서 찾아 표시합니다. 뺄셈이 들어가는 곳이 후보입니다.
셋. 정상이던 판을 하나 남겨 둡니다. 대조할 기준이 없으면 이상한 걸 못 알아봅니다.
넷. 결과물을 실제로 한 번 열어 봅니다. 검사 통과와 쓸 수 있는 것은 다릅니다.
다음에는 정상 판 여러 개에서 각 값의 범위를 뽑아 타당성 검사를 자동으로 만들 수 있는지 해보려고 합니다. 되면 이어서 적겠습니다.