AI가 없는 숫자를 만들어 넣었습니다 — AI글쓰기에서 수치를 막는 법
AI글쓰기로 AI콘텐츠를 만들다 보면 원본에 없던 숫자가 본문에 들어갑니다. 저는 이걸 여러 번 겪었습니다.
문제는 그 숫자가 그럴듯하다는 점입니다. 형식이 맞고 문맥에도 어울려서, 읽을 때는 이상하다고 못 느낍니다.
1. 틀리면 안 되는 값은 프로그램이 고정해서 넣습니다 2. 생성된 글에서 숫자를 전부 뽑습니다 3. 원본에 없는 숫자가 하나라도 있으면 막습니다 4. 프롬프트로 막으려 하지 않습니다
AI글쓰기 증상 — 없던 숫자가 생깁니다
증상 — 원본 자료에는 이름과 구성만 있는데, 나온 글에는 수치가 여럿 들어 있습니다.
원인 — 생성 모델은 그 자리에 올 법한 것을 채웁니다. 비어 있으면 채우려 합니다. 없는 것을 없다고 두는 것보다, 그럴듯한 것을 넣는 쪽이 문장이 자연스러워지기 때문입니다.
저는 처음에 프롬프트로 막으려 했습니다. "자료에 없는 수치는 절대 쓰지 마라" 를 여러 번 강조해서 넣었습니다. 줄기는 했는데 없어지진 않았습니다.
프롬프트로는 못 막습니다
지시는 부탁이고 검사만이 강제입니다. 대부분은 지키는데, 어쩌다 한 번 안 지킵니다.
그 "어쩌다 한 번" 이 문제입니다. 자동으로 발행되는 구조라면 그게 그대로 나갑니다.
| 방법 | 효과 |
|---|---|
| 프롬프트로 금지 | 줄어듭니다. 없어지진 않습니다 |
| 자료를 더 자세히 줌 | 줄어듭니다. 없어지진 않습니다 |
| 출력 뒤 대조 검사 | 막힙니다 |
해결 하나 — 고정할 값은 코드가 넣습니다
해결 — 가격·주소·상품명·날짜처럼 틀리면 안 되는 값은 생성에 맡기지 않습니다.
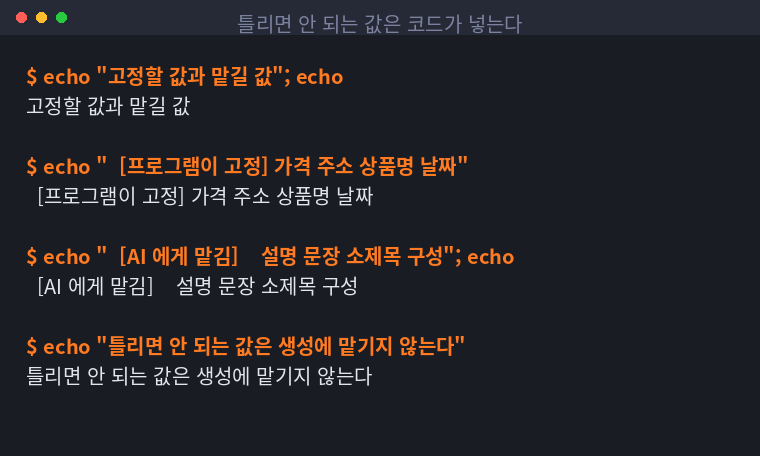
| 프로그램이 고정 | AI에게 맡김 |
|---|---|
| 가격·수량·날짜 | 설명 문장 |
| 주소·링크 | 소제목 |
| 상품명·이름 | 문단 구성 |
| 규격·성분 표기 | 도입·마무리 |
# 본문은 생성하되, 값은 자리표시자로 두고 나중에 코드가 채운다
body = generate(prompt)                       # "가격은 {{PRICE}} 입니다"
body = body.replace("{{PRICE}}", data["price"])
body = body.replace("{{URL}}", data["url"])
이렇게 하면 그 값들은 애초에 틀릴 수가 없습니다. 생성 결과와 무관하게 원본 그대로 들어갑니다.
해결 둘 — AI콘텐츠의 숫자를 대조합니다
나머지 숫자는 나온 뒤에 대조합니다.
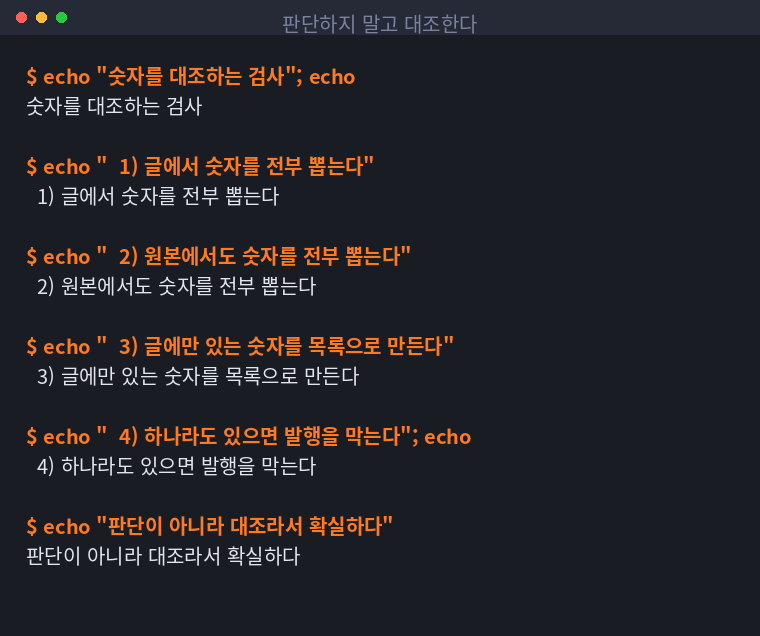
def unverified_numbers(text: str, sources: list[str]) -> list[str]:
    """글에는 있는데 원본 어디에도 없는 숫자를 찾는다."""
    src = set()
    for s in sources:
        src |= set(re.findall(r"\d[\d,.]*", s))
    found = set(re.findall(r"\d[\d,.]*", text))
    return sorted(found - src)

missing = unverified_numbers(body, [product_data, transcript, page_text])
if missing:
    raise BlockedError(f"원본에 없는 수치: {missing}")
판단이 아니라 대조입니다. "이 숫자가 맞아 보이나" 를 묻지 않고, "원본에 있나 없나" 만 봅니다. 그래서 확실합니다.
저는 처음에 이걸 AI에게 물어보게 만들었습니다. "이 글에 근거 없는 수치가 있나" 하고요. 답이 매번 달랐습니다. 같은 글을 두 번 넣었는데 한 번은 문제없다고 하고 한 번은 세 개를 지적했습니다. 그때 대조 방식으로 바꿨습니다.
대조할 때 주의할 것
그대로 쓰면 오탐이 많습니다. 몇 가지를 걸러야 합니다.
| 걸러야 할 것 | 예 |
|---|---|
| 서식·구조에서 나온 숫자 | 태그 속성, 스타일 값 |
| 목록 번호 | 1. 2. 3. |
| 날짜 형식 차이 | 2026-08-10 vs 2026년 8월 10일 |
| 단위 표기 차이 | 1,200 vs 1200 |
해결 — 검사 전에 숫자를 정규화합니다. 쉼표를 빼고, 검사 대상에서 태그를 걷어냅니다.
def norm(n: str) -> str:
    return n.replace(",", "").rstrip(".")
저는 이걸 안 하고 처음 돌렸다가 정상 원고가 전부 막혔습니다. 쉼표 하나 차이로 다른 숫자가 됐기 때문입니다. 검사기를 붙일 때는 오탐부터 확인해야 합니다.
못 잡는 것
숫자가 아닌 환각은 이 방법으로 안 잡힙니다.
| 잡힙니다 | 안 잡힙니다 |
|---|---|
| 없는 수치 | 없는 인증·수상 이력 |
| 없는 날짜 | 없는 원산지 |
| 없는 가격 | 과장된 표현 |
대안으로 이런 것들은 별도 검사를 붙였습니다. 원본에 없는 주장을 나열하게 하는 방식인데, 이쪽은 판단이 들어가서 오탐이 있습니다.
저는 숫자는 기계 대조로, 주장은 별도 검사로 나눠서 다룹니다. 성격이 다른 문제라 한 방법으로 묶으면 둘 다 어설퍼집니다.
확인 못 한 것
어느 정도 오탐이면 쓸 만한 것인지 는 아직 기준을 못 잡았습니다. 너무 빡빡하면 정상 원고가 막히고, 느슨하면 놓칩니다.
지금은 막힌 원고를 사람이 보고 판단하는 식인데, 그 비율이 얼마여야 적당한지는 확인하지 못했습니다. 숫자로 기준을 잡아야 할 것 같은데 아직 안 했습니다.
판정 — 계속 쓴다
대조 검사는 확실히 값어치가 있습니다. 판단이 아니라 대조라서 결과가 일정합니다.
고정할 값을 코드가 넣는 방식이 더 근본적입니다. 검사로 잡는 것보다 애초에 틀릴 수 없게 만드는 쪽이 낫습니다.
프롬프트만으로는 안 됩니다. 줄어들 뿐 없어지지 않습니다. 자동 발행이라면 그 "어쩌다 한 번" 이 그대로 나갑니다.
직접 하실 분께
하나. 틀리면 안 되는 값은 생성에 맡기지 마세요. 자리표시자로 두고 코드가 채웁니다.
둘. 숫자는 뽑아서 대조합니다. 판단시키지 말고 있나 없나만 봅니다.
셋. 대조 전에 정규화합니다. 쉼표·단위 차이로 정상 원고가 막힙니다.
넷. 검사기를 붙였으면 정상 원고가 통과하는지 부터 확인합니다. 막는 것보다 이게 먼저입니다.
다음에는 숫자가 아닌 주장까지 기계로 대조할 방법이 있는지 찾아보려고 합니다. 되면 이어서 적겠습니다.