데이터수집하다 차단당했습니다 — 크롤링 대신 공식 API로 바꾼 이유
공개된 자료를 데이터수집하려고 크롤링을 돌렸다가 차단당했습니다. 처음엔 잘 되다가 어느 순간부터 아무것도 안 들어왔습니다.
대기 시간을 늘리고 재시도를 넣어도 안 풀렸습니다. 결국 공식 API로 바꿨고, 그게 처음부터 옳은 선택이었습니다.
이 글은 그 과정과, 긁기 전에 확인했어야 할 것들입니다.
1. robots.txt 와 이용약관을 먼저 봅니다
2. 공식 API가 있는지 찾습니다
3. 있으면 그걸 씁니다
4. 없고 허용된 범위라면, 그때 조심해서 긁습니다
증상 — 어느 순간부터 아무것도 안 들어옵니다
증상 — 처음 며칠은 잘 됩니다. 그러다 조회 결과가 0건이 되고, 나중에는 연결 자체가 안 됩니다. 코드는 그대로인데 결과만 비어 옵니다.
이때 코드를 의심하기 쉽습니다. 저도 파싱 규칙이 틀렸나 싶어 한참 봤습니다. 상대 화면이 바뀌었나 하고 직접 열어 봤는데 브라우저로는 잘 열렸습니다. 브라우저는 되는데 프로그램만 안 되면 그때부터는 차단을 의심해야 합니다.
차단은 단계적으로 옵니다
한 번에 막히지 않습니다. 그래서 초반에 "잘 되네" 하고 넘어갑니다.
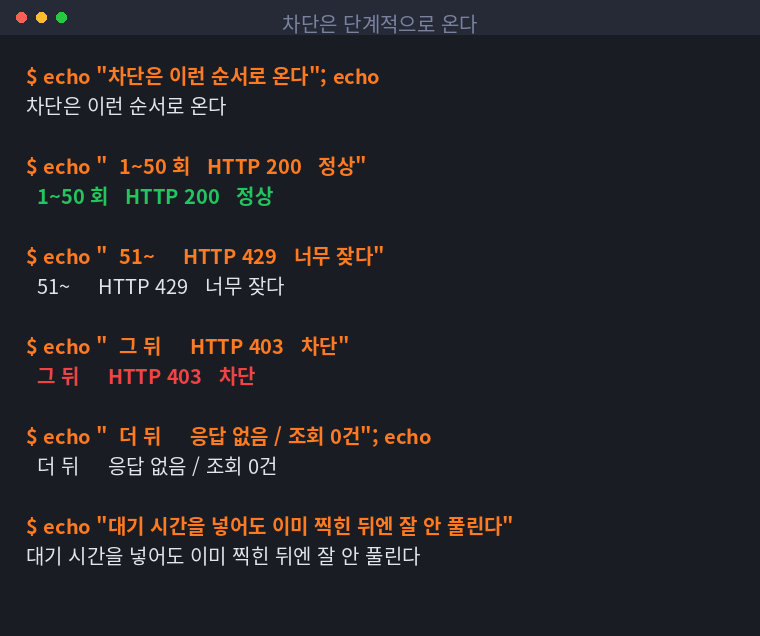
| 단계 | 응답 | 이때 해야 할 것 |
|---|---|---|
| 초반 | 200 |
요청 간격을 넉넉히 둡니다 |
| 잦아지면 | 429 |
여기서 멈춰야 합니다 |
| 무시하고 계속 | 403 |
이미 늦었습니다 |
| 그 뒤 | 응답 없음·빈 결과 | 회선 단위로 막힌 상태 |
429가 경고 신호입니다. 저는 이걸 "잠깐 기다렸다 다시 하면 되는 것"으로 봤습니다. 그래서 대기 시간만 늘리고 계속 돌렸습니다. 그게 상황을 악화시켰습니다.
한 번 회선 단위로 찍히면 대기 시간을 늘려도 잘 안 풀립니다. 저는 간격을 열 배로 늘려 봤는데도 그대로였습니다.
원인은 제 쪽에 있었습니다
원인 — 짧은 시간에 너무 많이 불렀습니다. 그리고 그 사이트가 자동 수집을 어떻게 다루는지 미리 확인하지 않았습니다.
robots.txt 를 먼저 봤어야 했습니다. 여기에 무엇을 긁어도 되는지, 얼마나 천천히 와야 하는지가 적혀 있습니다.
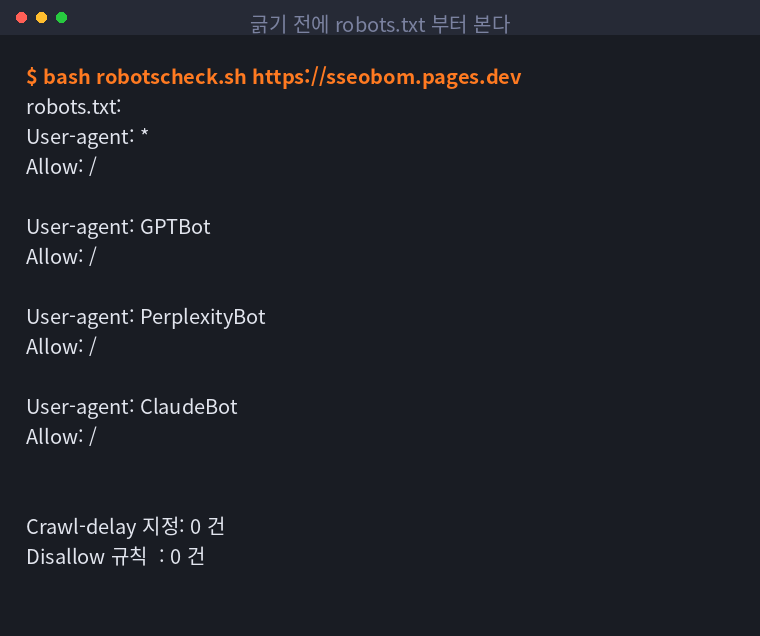
| 항목 | 뜻 |
|---|---|
Disallow: /경로 |
그 경로는 긁지 말라는 뜻 |
Crawl-delay: 10 |
요청 사이에 10초는 두라는 뜻 |
User-agent: * |
모든 자동 프로그램에 적용 |
이걸 지키는 것은 법적 의무는 아니지만, 지키지 않으면 차단당합니다. 그리고 지키지 않을 이유도 없습니다.
해결 — 공식 API로 바꿨습니다
해결 — 같은 데이터를 제공하는 공식 경로가 있었습니다. 진작 찾아봤어야 했습니다.
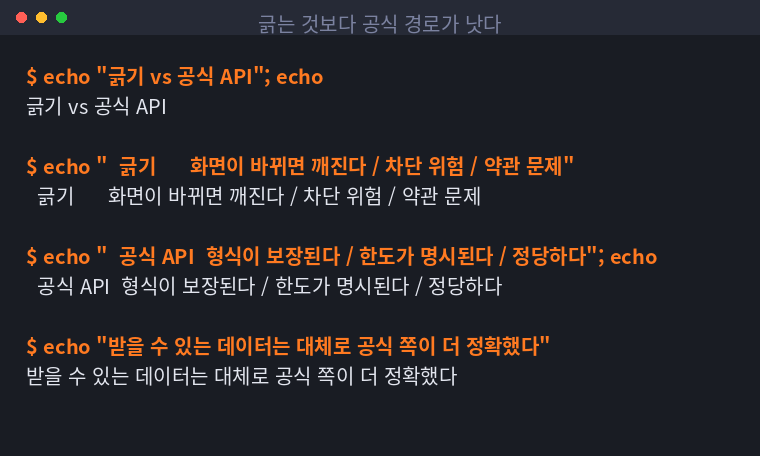
| 긁기 | 공식 API | |
|---|---|---|
| 형식 | 화면이 바뀌면 깨집니다 | 보장됩니다 |
| 한도 | 어디까지 되는지 모릅니다 | 문서에 적혀 있습니다 |
| 차단 위험 | 있습니다 | 한도만 지키면 없습니다 |
| 약관 | 문제가 될 수 있습니다 | 정당합니다 |
| 데이터 품질 | 화면에 보이는 것만 | 더 많고 정확한 경우가 많습니다 |
마지막 줄이 뜻밖이었습니다. 저는 API가 제한적일 거라고 짐작했는데, 실제로는 화면에 안 나오는 항목까지 들어 있었습니다. 화면은 사람이 보기 좋게 줄여 놓은 것이고, API가 원본에 가깝습니다.
긁는 게 불가피할 때
공식 경로가 없고, 약관상 허용된 범위라면 그때는 이렇게 합니다.
1. robots.txt 의 Disallow 와 Crawl-delay 를 지킵니다
2. 프로그램 이름표(User-Agent)에 연락처를 적습니다 — 문제가 되면 상대가 연락할 수 있게
3. 요청 간격을 넉넉히 둡니다. 급할 이유가 없습니다
4. 429가 오면 그날은 멈춥니다
5. 받은 것은 캐시해서 같은 걸 두 번 안 받습니다
HEADERS = {"User-Agent": "내프로젝트/1.0 (연락처: 내이메일)"}

for url in urls:
    resp = fetch(url, headers=HEADERS)
    if resp.status == 429:
        log("429 — 오늘은 여기까지")
        break                      # 재시도하지 않고 끝낸다
    save_cache(url, resp.body)
    time.sleep(DELAY)              # robots.txt 가 요구하는 간격 이상
429에서 재시도하지 않고 끝내는 것이 핵심입니다. 재시도 로직이 있으면 상황을 더 나쁘게 만듭니다.
주의할 것이 하나 더 있습니다. 여러 프로그램이 같은 회선에서 동시에 돌면, 각자는 간격을 지켜도 상대 쪽에서 보기엔 한꺼번에 몰려오는 것으로 보입니다. 저는 이걸 나중에 알았습니다.
# 프로그램마다 따로 세면 합쳐서 얼마나 부르는지 모른다
# 파일 하나에 공유 상태를 두고 전체 호출을 센다
with locked("fetch_state.json"):
    state = load()
    if state["today"] >= DAILY_MAX:
        raise RuntimeError("오늘 수집 상한 도달")
    state["today"] += 1
    save(state)
대안으로 아예 시간대를 나누는 방법도 있습니다. 프로그램마다 도는 시각을 다르게 잡으면 겹치지 않습니다. 저는 이쪽이 더 단순해서 이렇게 두고 있습니다.
확인 못 한 것
차단이 얼마나 지나면 풀리는지는 확인하지 못했습니다. 며칠 뒤에도 그대로였고, 그 뒤로는 공식 API로 옮겨서 다시 시도할 이유가 없어졌습니다.
회선 단위로 막힌 것인지 계정·프로그램 단위인지도 구분하지 못했습니다. 다른 회선에서 같은 요청을 넣어 봐야 아는데, 그건 사실상 차단을 우회하는 시도라 하지 않았습니다.
다시 안 겪으려면
| 장치 | 무엇을 막나 |
|---|---|
사전에 robots.txt 확인 |
애초에 안 되는 것을 시도하는 것 |
| 공식 API 먼저 찾기 | 불필요한 긁기 |
429에서 즉시 중단 |
경고를 무시해 차단으로 가는 것 |
| 연락처를 밝힌 이름표 | 오해로 막히는 것 |
| 캐시 | 같은 요청을 반복하는 것 |
판정 — 안 쓰기로 했다
긁는 방식은 접었습니다. 공식 경로가 있는데 굳이 긁을 이유가 없었습니다.
이유는 셋입니다.
- 깨집니다. 상대 화면이 바뀌면 그날로 멈춥니다. 화면은 언제든 바뀝니다.
- 위험합니다. 차단당하면 그 회선으로는 다시 못 갑니다. 다른 작업까지 영향을 받습니다.
- 더 나은 게 있었습니다. 공식 API가 데이터도 더 많고 형식도 안정적이었습니다.
공식 경로가 아예 없는 경우라면 이야기가 다릅니다. 그때는 위의 규칙을 지켜서 조심스럽게 하되, 상대 서버에 부담을 주지 않는 선을 지키는 게 맞습니다.
직접 하실 분께
하나. 긁기 전에 공식 API가 있는지부터 찾으세요. 저는 이 순서를 건너뛰어서 시간을 버렸습니다.
둘. robots.txt 를 봅니다. 30초면 됩니다.
셋. 429가 오면 그날은 멈춥니다. 재시도로 밀어붙이지 않습니다.
넷. 이름표에 연락처를 적습니다. 상대가 물어볼 수 있게 해두는 것이 서로에게 낫습니다.
다음에는 공식 API 쪽 한도 안에서 필요한 데이터를 다 받을 수 있는지, 받는 주기를 어떻게 잡을지 정리해보려고 합니다. 되면 이어서 적겠습니다.